Klantwerk · 2026
Onderhoudstickets automatisch indelen
Een eigen getraind classificatiemodel dat tickets in dertig categorieën sorteert
- Voor
- Een vastgoedgroep in Gent
- Mijn rol
- Freelance AI engineer, data, training en uitrol
- Periode
- 2026
- Status
- In productie sinds maart 2026
Het probleem
Honderden onderhoudsmeldingen per maand, in het Nederlands en het Engels, moesten met de hand in de juiste categorie van het facility-systeem gezet worden voor ze bij de juiste technieker belandden. De categorieën zijn fijnmazig (ventilatie, toilet, keukentoestel, lift…) en de teksten kort en slordig. Een generiek taalmodel per ticket bevragen was te traag en te duur voor iets dat elke vijf minuten moet draaien.
Wat ik bouwde
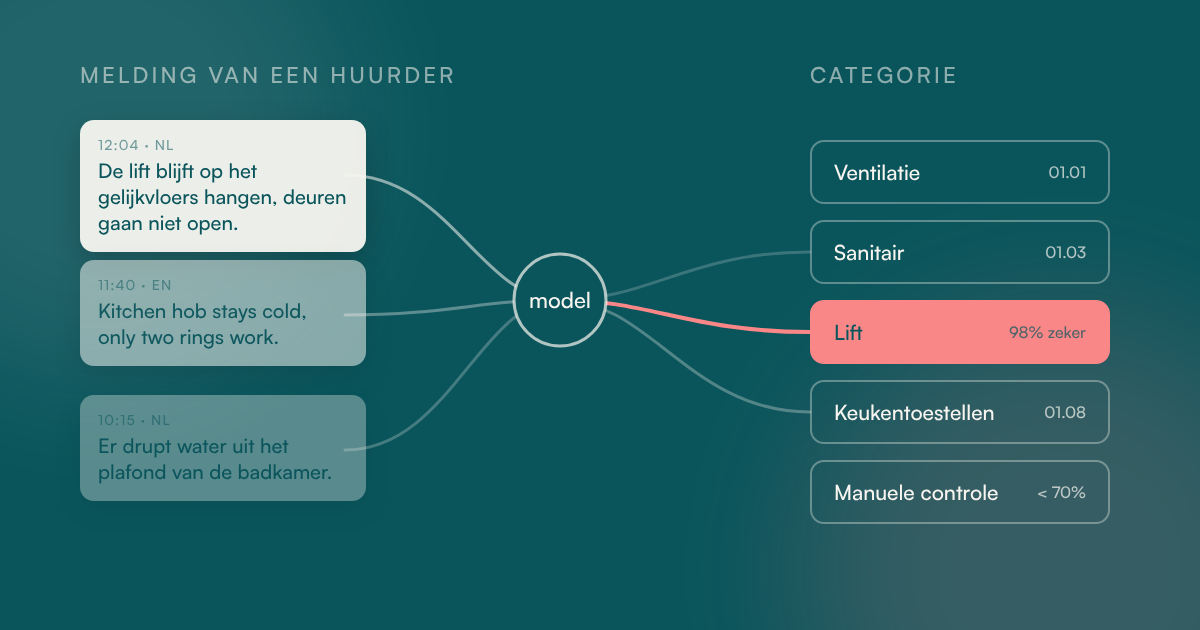
- Een eigen getraind classificatiemodel: SetFit op een meertalige XLM-RoBERTa-encoder, contrastief gefinetuned op enkele duizenden gelabelde tickets, met een logistische-regressiekop en temperatuurkalibratie zodat de zekerheidsscore ook iets betekent.
- Vergeleken met klassieke baselines (TF-IDF met logistische regressie, XGBoost) en per versie geëvalueerd op een vaste testset; de drempel voor automatisch toewijzen werd op de kalibratiecurve gekozen.
- Een lichte pipeline in Docker die elke vijf minuten nieuwe tickets ophaalt, voorspelt, de categorie terugschrijft naar het facility-systeem en elke voorspelling logt in PostgreSQL. Onder de drempel gaat het ticket naar een mens.
- Een hertrainingslus: een maand later worden de voorspellingen vergeleken met de correcties van het facility-team, en die correcties voeden de volgende modelversie.
Resultaat
- In productie sinds maart 2026. Over de eerste zes weken was 98 procent van de automatisch toegewezen tickets juist.
- Het model draait op CPU, kost per ticket een fractie van een LLM-call en levert een gekalibreerde zekerheid in plaats van een gok.
- De hertrainingslus maakt van elke correctie door het team trainingsdata, zodat het model meegroeit met nieuwe soorten meldingen.
Wat ik eruit leerde
Voor een vaste set categorieën en korte teksten wint een klein, zelf getraind model van een groot taalmodel: sneller, goedkoper en meetbaar. Een LLM is pas de juiste keuze als het antwoord open is.